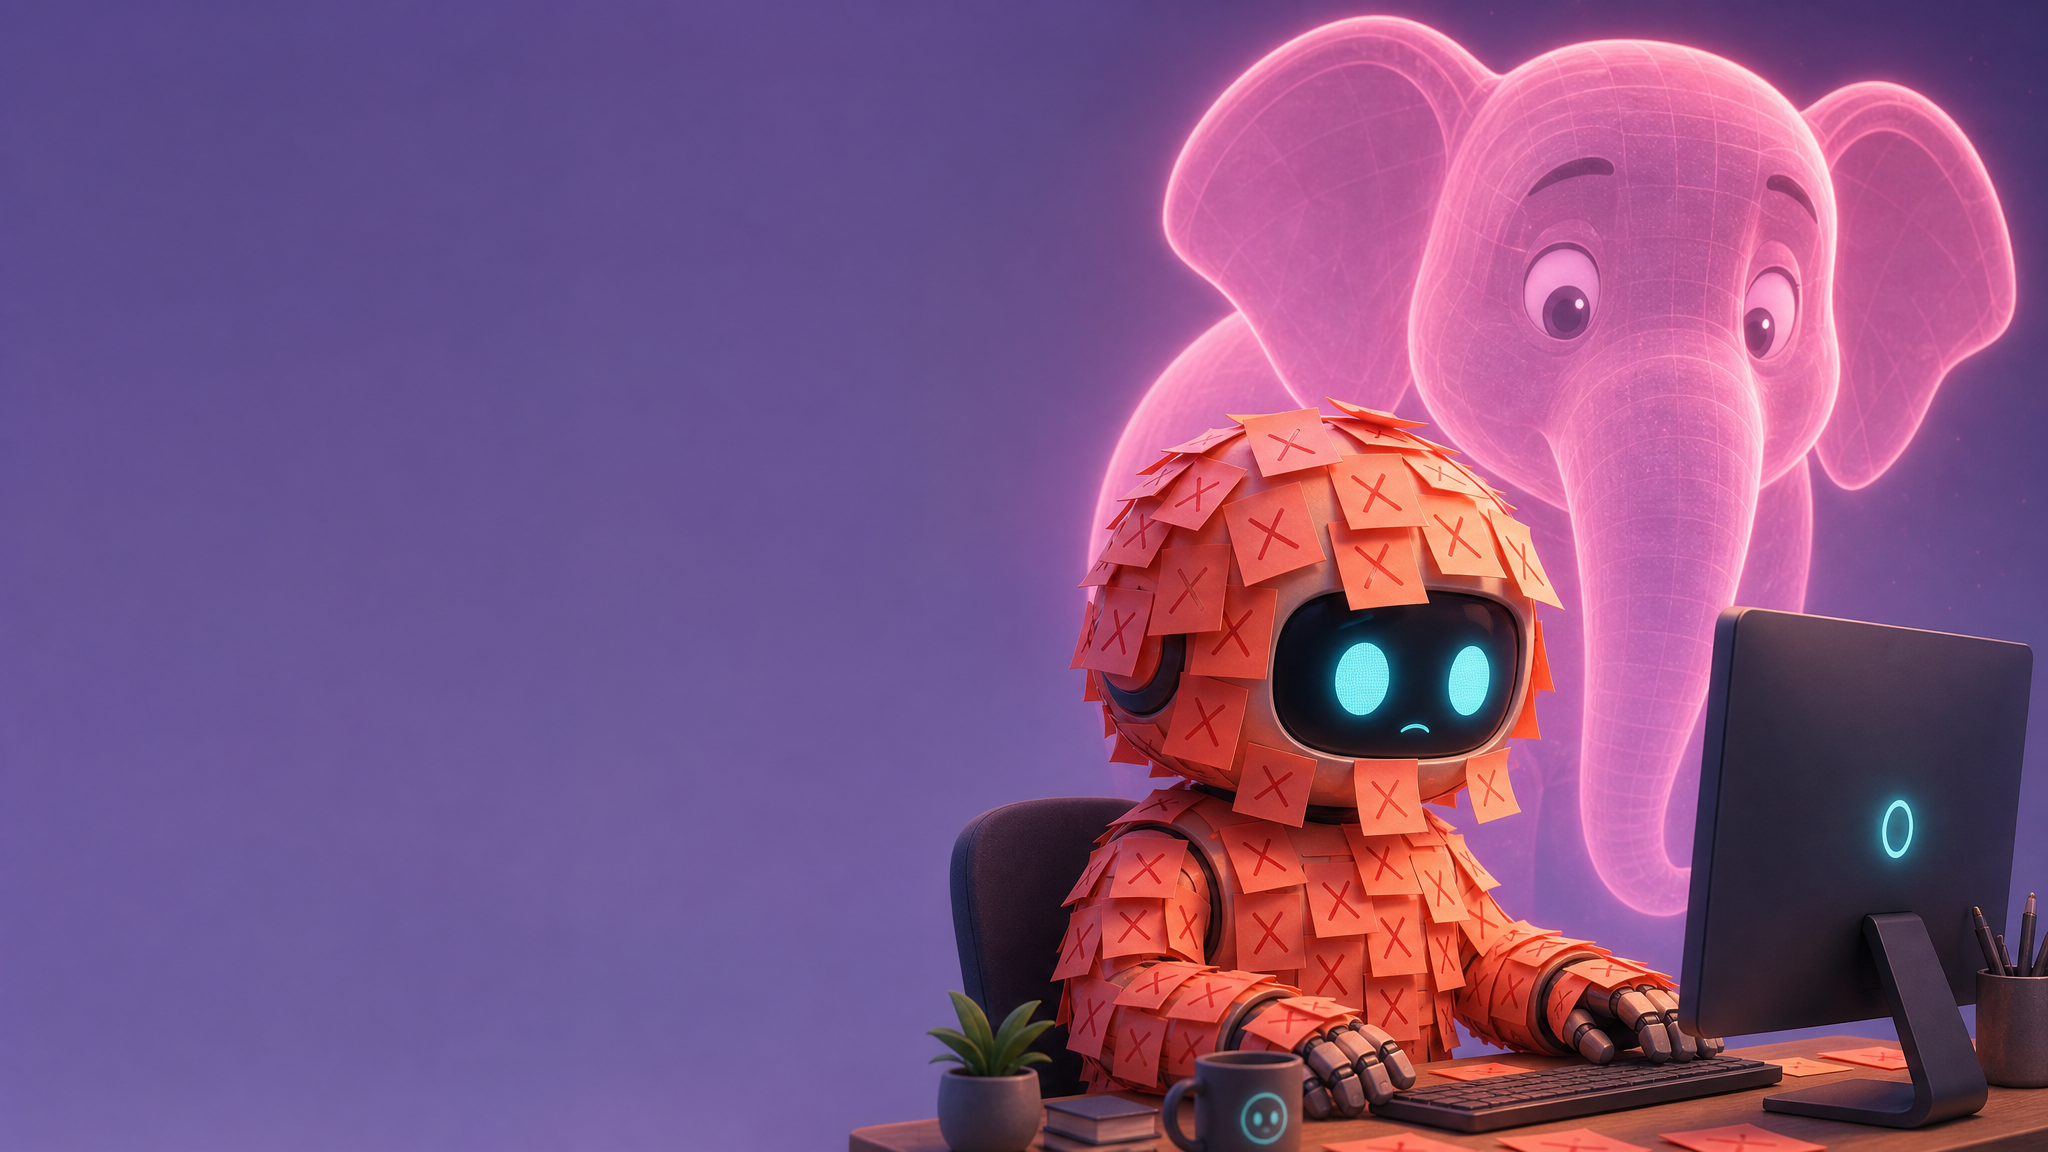
本文揭示了在编写 Prompt 时使用“不要”、“严禁”等否定指令的弊端。通过剖析大模型的正向选择机制、粉红大象效应及训练本能,提出将“禁止黑名单”改为“正向白名单”的优化策略,从而有效提高 AI 执行的精准度。
| 工具 | 应用场景 | 改造前 (否定指令/踩刹车) | 改造后 (正向指令/打方向盘) | 解决的底层问题 |
|---|---|---|---|---|
| 返回字段 | 不要包含手机号、身份证号 | 返回字段限定为 {订单号,金额,创建时间} 三项 | 规避「粉红大象效应」,避免未被封堵的衍生字段(如半脱敏邮箱)泄露。 | |
| 改文件 | 不要修改其他文件;不要引入新依赖 | 仅修改当前文件;依赖限用项目已有的 pandas | 利用 Token 的「正向选择」,把目标词概率顶上去,精准指路。 | |
| 出代码 | 不要解释,不要给建议,不要加注释 | 直接输出可运行 Python,仅函数体 | 解决 AI 天生想帮忙的「训练本能」,阻断无意义的自作主张。 |
你越写「不要」,AI 越 顶风作案 。不是它不听话,是你一直在用禁止的方式,跟一个 天生想帮忙 的家伙沟通。
你写 Prompt 的时候,是不是特别顺手就甩出 不要、严禁、别 这种否定句?
不要给建议、严禁遗漏某个字段、别输出多余的解释,我打赌你最近一次写 Prompt,十有八九也这么开过头。我自己曾经就这么持续写了大半年,直到有一天发现一件 特别荒诞的事 : 我越写“不要”,AI 越是把那些“不要”的东西塞给我。
最典型的是出代码这件事,我接客户项目、前后端一起搞,经常让 AI 直接给我接口代码,Prompt 里白纸黑字写着:不要解释,不要给建议,直接输出可运行的代码。
结果呢?
它每次开头先来一句“好的,我来帮你实现这个功能”,末尾还要附一段 “几点优化建议供你参考” 。
我越写不要建议,它越觉得 不给我建议就对不起我 。
有一次我让它批量生成几个接口,只要代码、别废话,强调了三遍。它倒好,代码是给了,可每个接口前面都垫一段“这个接口的作用是…”,后面还跟“使用时注意…”。我删都删不及,说实话,那一刻真有点想摔键盘。
那种感觉怎么说呢?
就像你跟服务员说“不要香菜”,他每道菜都给你撒一把,还一脸真诚地说 “提味儿” 。
今天这篇不跟你讲 Prompt 怎么写得花里胡哨,就聊一个我用了好几次返工才琢磨明白的事:为什么你越写“不要”,AI 越跟你顶风作案,以及怎么用一个 特别小的改动 ,把它治住。建议先收藏,下次写 Prompt 前看一眼。
📌 本文看点
01 越禁越来的翻车现场
02 否定换正向改造表
03 要比不要的三层机制
01 CASE
前面那种多两句废话还好,删删就完了。真正让我 破防 的,是一次直接被客户骂。
做个后台系统的导出接口,我让 AI 写导出逻辑。这种活儿最怕啥?怕它把 用户的敏感信息 带出来。所以我 Prompt 里专门加粗写了一条:返回结果里不要包含用户的手机号和身份证号,必须脱敏。我当时还觉得自己想得挺周到。
跑出来一看,代码能跑,手机号、身份证也确实脱敏了。可它觉得前端列表可能要显示联系方式、方便客服联系,自作主张多带了一个 masked_email 字段, 半脱敏的邮箱 🤷♀️。
我自己测的时候没注意,提交给测试,测试也没拦住。直到客户那边的安全扫描一跑,直接标红: 接口泄露半脱敏邮箱 。
那天晚上改到挺晚,我一边改一边复盘,越想越后怕,这批数据要是真发出去,客户那边得炸。我写了不要手机号、不要身份证,它确实没给;可不要这东西是有限的,我只禁了我想得到的两个,它就在我没禁的第三个地方, 贴心地给我补了一个 。
就像你跟小孩说别碰花瓶、别碰电视,他确实没碰,转头把鱼缸给掀了,你禁得越细,他越能在 你没想到的角落搞出新花样 。
「否定指令的本质是堵窟窿,你堵一个,它在别处冒一个。你永远禁不过来。」

既然堵不住,那就换个思路:别堵了, 引它往该走的方向去 。
02 METHOD
后来我换了个写法,说起来真不起眼,就一个动作, 把不要做什么改成只做什么 。
还是导出接口那个需求。原来我的 Prompt 是一串否定:
改造前 · 否定指令
不要包含手机号、身份证号;不要给建议;不要加注释;不要修改其他文件;不要引入新依赖。
改完之后变成这样:
改造后 · 正向指令
输出一段 Python 函数,仅包含导出逻辑,无注释无解释;返回字段限定为 {订单号,金额,创建时间} 三项;仅修改当前文件;依赖限用项目已有的 pandas 。
看出区别没?
换句话说,我把一串禁止项换成了 白名单 。与其告诉它 100 个不要,不如告诉它 1 个要。它读到的时候,注意力首先落在该做什么上,而不是先在脑子里把手机号、身份证这些被禁的词全激活一遍。
后来我把这套写法整理成一张小表,每次写 Prompt 照着填,特别省事,也给你抄一份,这是 真能截图带走 的:

这里还有个关键细节就是:✅正向行为那列,我刻意让它比禁止项那列字多、放前面。因为模型读 Prompt 是有位置偏好的, 开头和正向描述吃到的注意力最多 。禁止项不是不能写,是退到后面当个补充提醒就行。
💡 小技巧:先把要它给我什么写成一两句正向的话,放开头;再把绝对不能碰什么压成几个短词,丢最后面。先后顺序一换,效果差很多。
效果上我自己的体感是:我现在写 Prompt,第一反应不再是列不要,而是先写一句我要什么。这么一换, 返工率明显下来了 ,尤其是它自作主张加东西这种事,基本没了。不是它变聪明了,是我没再给它自作主张的余地。
03 WHY
你可能会问:同样是几个字,不要做 X 和只做 Y,凭啥差这么多?这事儿我后来琢磨了挺久,想明白了三层,越想越觉得 反直觉 。
第一层,模型生成文字,本质是“正向选择”。
模型它其实每次都在挑下一个最可能的词。
不要手机号这句,只能微弱地把手机号这个词的概率往下压一点点;而返回字段限定为{订单号,金额,时间},是直接把这几个词的概率顶上去。一个是 踩刹车 ,一个是 踩油门打方向盘 。
你说,哪个指路更准?
第二层,就是那个粉红大象。
你让自己别想粉红大象,脑子里先蹦出来的,就是粉红大象。模型也一样,你写不要手机号,它得先把手机号这个词 激活、放到台面上 ,才能决定不输出。你越禁,它越惦记。
所以真正聪明的写法是:
「别告诉它别想粉红大象,告诉它想一只蓝色的猫。」
第三层,是它的训练本能。
模型是被训练成尽量有用的,它的本能就是多给信息、给建议、关联相关概念。
你写不要建议,其实是在跟它的训练本能对着干,它觉得不给是不是没用啊,然后变着法儿地贴心。正向指令的好处,是顺着它的本能:你明确告诉它要什么,它就理直气壮地只给那个, 不用在该不该多给上纠结 。
这三层加起来,就一句话:
「否定指令是踩刹车,正向指令是打方向盘。刹车踩得越狠,它越不知道往哪开;方向盘打得准,它自己就开过去了。」

∞ THE END
回头看看,我以前写 Prompt,活像在跟 AI 较劲:它不听话,我就加严禁;还不行,再加一条铁律。结果就是,我越禁,它越觉得自己没帮足, 变着花样给我加餐 。
如果现在有个刚入门、正被 AI 不听话折磨的朋友站我面前,我最想拍他肩膀说一句:
「别再跟 AI 较劲不许做什么了,你较不过它的训练本能。」
你写十条不要,不如写一条要。把不要做坏事换成只做好事,这一步看起来不起眼,但这是我用一次次返工换来的。与其花时间堵窟窿,不如花十秒钟想清楚: 我到底要它给我什么 。想清楚这句话,写下来,比堆一百条严禁都管用。
💡 小技巧:下次写 Prompt,先别急着敲键盘,先问自己一句:我到底要它给我什么?把答案写下来,再开口。
真正该改的,从来不是 AI,是你那句不要。
END
我是艾启蒙 ,热衷于分享 AI 观察与 Prompt 工程实战干货。
你被 AI 顶风作案气得最狠的那次,写了句什么 “不要” ?欢迎在评论区聊聊,咱们一起把坑填了。 如果这篇文章对你有帮助,点个「分享」,让更多想学AI编程的朋友看到。 觉得内容有价值?设个邮箱订阅,以后每次更新都能第一时间收到。
您可能也喜欢这些文章

加载评论中…